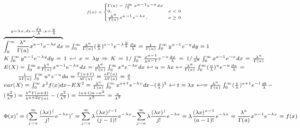
- 方差衡量的是資料集相對於其平均值的離散程度。
- 它是透過偏差平方的平均值來計算的,以防止結果相互抵消。
- 它在金融領域是評估風險的基礎,在科學領域是確定估計值準確性的基礎。
- 它的平方根就是標準差,透過標準差可以還原成原來的測量單位。

當我們深入研究數據時,常常只關注平均值,但簡單地說平均值是某個特定值有時會讓我們一頭霧水。要真正理解資訊背後的含義,我們需要知道數據是否高度集中,或者是否存在相當大的離散度,從而導致平均值的可靠性降低。
這時,變異數就派上了用場,它是一種可以量化這種變異性的工具。簡單來說,它衡量的是一個群體中的數值平均偏離其中心值的程度,從而使我們能夠發現那些原本會被忽略的異常值或不一致之處。
方差究竟是什麼?
準確地說,變異數是衡量離散程度的指標,它描述了資料集相對於其算術平均值的變異性。簡單來說,它告訴我們一組數字彼此之間是否非常相似,或者它們是否分散在整個圖表中。
從歷史角度來看,是羅納德·費雪在 1918 年提出了這個概念。費雪意識到,為了分析自然和遺傳變異的原因,使用標準差的平方比使用標準差本身要有用得多,從而奠定了現代統計學的基礎。
有趣的是,變異數總是大於或等於零。這是因為,無論原始偏差是正還是負,當差值平方時,結果在數學上都不可能為負。
指數存在的理由:為什麼要平方?
很多人不明白為什麼我們不直接將每個數據點與平均值之間的差值相加。原因很簡單:根據數學原理,所有資料點與平均值的偏差總和總是等於零。正值和負值互相抵消,會讓我們產生錯誤的變異性錯覺。
透過對這些殘差進行平方,我們可以消除負號,並確保任何偏離平均值的情況(無論是向上或向下)都會對最終結果產生正面影響。因此,只有當資料集中的所有資料都完全相同時,我們才能得到方差為零的結果。
如何計算:逐步講解
計算方差並不需要數學天才,只需遵循一定的邏輯順序即可。首先,我們必須求出這組數據的算術平均值。得到平均值後,我們計算每個資料點與該平均值的差值,這個過程稱為獲得殘差。
下一步是將每個殘差平方,然後將它們全部相加。最後,我們將總和除以觀測值的數量。這裡有一個重要的區別:如果我們處理的是整個總體,則除以 N;但如果只是一個樣本,則除以n-1以獲得無偏估計量。
隨機變數的方差
當我們進入機率論領域時,隨機變數 X的變異數定義為其與平均值偏差平方的期望值。從數學上講,這可以表示為變數與其自身的協方差,或表示為機率分佈的二階累積量。
根據變數的性質,計算方法有所不同。如果變數是離散的(例如擲骰子),我們將偏差的平方乘以其機率,然後將所有偏差值相加。如果變數是連續的(例如人的身高),則必須使用機率密度函數在其整個取值範圍內的積分。
與標準差的主要區別
這兩個概念很容易混淆,因為它們本質上衡量的是同一件事。差別在於單位。變異數以平方單位表示(例如,如果我們測量的是米,變異數的單位就是平方米),這使得它難以直觀理解。
為了解決這個問題,我們對變異數取平方根,得到標準差。這樣就將度量值還原到其原始單位,使我們能夠說,例如,工資與平均值的平均偏差為 200 歐元,而不是說歐元的平方。
實際應用和實際效用
方差並非只是學術探討,它在現實世界中有著至關重要的應用。在金融領域,方差直接反映了風險。如果兩項投資預期收益相同,謹慎的投資人會選擇方差較低的那項,因為其結果較可預測。
在工業領域,它用於品質控制。零件製造過程中的低變異性意味著製程穩定,產品幾乎完全相同。另一方面,變異數分析 (ANOVA)可以比較不同組別,以確定它們平均值之間的差異是否具有統計意義。
它對於創建高效且一致的估計量也至關重要。如果一個估計量的變異數盡可能小,那麼它就是高效率的,這可以降低我們所抽取的樣本與總體真實值偏差過大的風險。
特殊情況和限制
並非所有分佈都有變異數。例如,柯西分佈沒有數學期望,因此也沒有變異數。類似地,有些帕累托分佈雖然有平均值,但如果其指數落在特定範圍內,則沒有變異數。
另一個缺點是對異常值的敏感度。因為我們對差異進行平方運算,所以一個距離平均值極遠的資料點就可能大幅增加方差,從而扭曲對資料集整體離散程度的感知。
為了緩解這個問題,一些統計學家使用變異係數,它是標準差與平均值的比值。由於它是一個無量綱值,因此可以比較平均數差異很大的兩組資料的離散程度,而不會受到尺度的影響。
運用變異數可以幫助我們理解資料的結構,從簡單的薪資樣本到複雜的常態分佈曲線-方差越小,曲線越高越窄。掌握了變異數的概念,我們就能從對平均值的膚淺解讀,轉向對任何研究現象的變異性進行批判性和深入的分析。