- Les implants cérébraux invasifs permettent de convertir les tentatives de parole en voix quasiment en temps réel, rétablissant ainsi la communication chez les patients paralysés.
- Les techniques non invasives (MEG, IRMf, EEG) combinées à de grands modèles de langage et d'images peuvent reconstruire des phrases et des scènes perçues ou imaginées.
- Les progrès actuels permettent de décoder des tâches et des contenus spécifiques, mais ils ne nous permettent toujours pas de lire l'intégralité du flux spontané de la pensée humaine.
- Le développement de ces neurotechnologies exige des cadres éthiques et juridiques solides pour protéger la vie privée mentale et garantir une utilisation responsable.
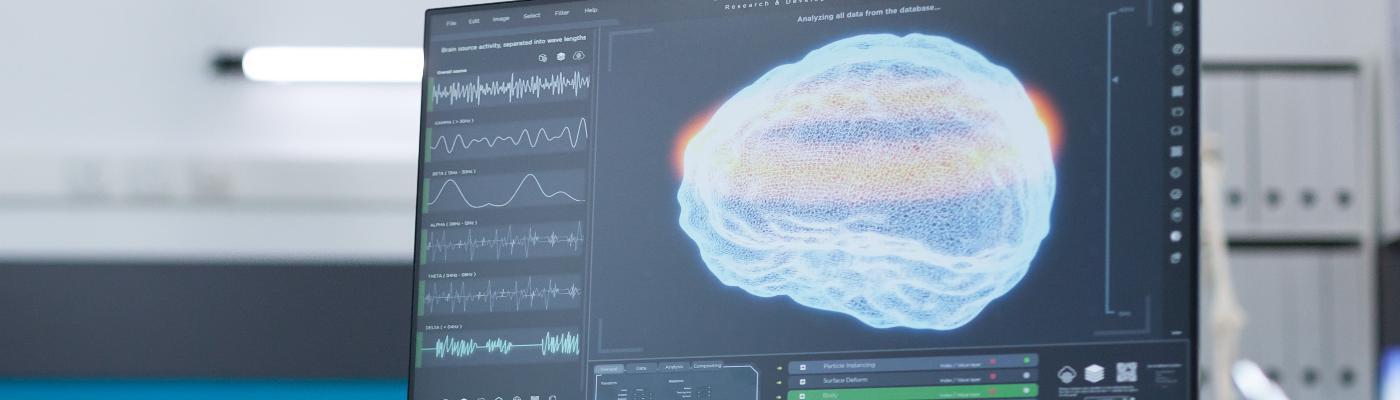
L'idée de lire dans les pensées grâce à l'intelligence artificielle est passée du statut de rêve de science-fiction à celui de domaine scientifique très sérieux. Partout dans le monde, des laboratoires rivalisent pour décoder ce que nous pensons, voyons ou imaginons à partir de l'activité cérébrale. Aujourd'hui, il ne s'agit plus seulement d'hypothèses : il existe des implants qui convertissent les pensées en parole quasiment en temps réel et des systèmes non invasifs capables de reconstruire des phrases, voire des images, à partir des signaux cérébraux.
Ce scénario ouvre la voie à une multitude d'applications, de la restauration de la communication pour les personnes paralysées au développement de nouvelles formes d'interaction avec les ordinateurs. Mais il soulève également d'importants dilemmes éthiques concernant la confidentialité des données psychiques, le consentement et les risques d'utilisation abusive. Examinons, avec calme et précision, la réalité des neurotechnologies basées sur l'IA pour le décodage de la pensée, leurs capacités actuelles et les défis à venir.
Des implants cérébraux qui transforment les pensées en paroles en quelques secondes
L'une des avancées les plus spectaculaires de ces dernières années est la mise au point d'un implant cérébral capable de transformer des signaux neuronaux en parole audible en quelques secondes seulement. Publié dans une revue scientifique de premier plan en 2025, ce système représente un bond qualitatif dans le domaine des interfaces cerveau-ordinateur (ICO) pour les personnes ayant perdu la parole.
Jusqu'à récemment, la plupart des interfaces cerveau-ordinateur (BCI) vocales étaient plutôt maladroites : l'utilisateur devait mentalement formuler une phrase entière pour que le système la traite et génère une sortie vocale ou textuelle. Il en résultait des conversations décousues, ponctuées de longs silences, bien loin du rythme naturel d'un dialogue quotidien.
Le nouvel implant a toutefois permis de réduire le temps de décodage à environ 3 secondes par mot ou groupe de mots . Ce n'est pas aussi rapide qu'une conversation en face à face, mais c'est bien plus performant que les technologies précédentes et cela permet des interactions beaucoup plus fluides et naturelles.
Cette avancée majeure repose sur l'association d' électrodes haute densité et d'algorithmes d'intelligence artificielle avancés . L'implant, une feuille flexible dotée de centaines de contacts, est placé à la surface du cortex cérébral responsable du contrôle de la parole et enregistre simultanément l'activité de milliers de neurones.
Ces signaux sont envoyés à un système externe qui, grâce à des modèles d'apprentissage profond, identifie les schémas neuronaux associés aux phonèmes, aux mots et aux structures de la parole . Une fois décodés, ils sont transmis à un synthétiseur vocal qui génère une parole audible en temps quasi réel.
Le cas d'Ann : retrouver sa voix après des années de silence
Au-delà de l'ingénierie, l'une des histoires qui illustre le mieux l'impact humain de ces neurotechnologies est celle d' Ann, une femme qui a perdu la parole après avoir subi un accident vasculaire cérébral du tronc cérébral en 2005. Les lésions l'ont placée dans une situation où son esprit est resté intact, mais son corps avait perdu la capacité d'articuler des mots.
Dix-huit ans plus tard, Ann a subi une intervention chirurgicale au cours de laquelle une fine feuille munie de 253 électrodes a été implantée à la surface de son cortex cérébral, responsable de la parole. Ce dispositif enregistre simultanément l'activité électrique de milliers de neurones qui s'activent lorsqu'elle tente de parler, même si ses muscles ne répondent plus.
La magie opère lorsque ces données sont combinées à des algorithmes d'intelligence artificielle spécialement entraînés pour ce cas précis. Pendant des mois, le système a appris à associer des schémas neuronaux spécifiques à des mots et à des mouvements articulatoires qui, chez une personne saine, produiraient des sons.
Les chercheurs souhaitaient aller plus loin et ne se contentaient pas d'une voix robotique générique. Ils ont récupéré des enregistrements vidéo du mariage d'Ann , antérieurs à son AVC, et les ont utilisés pour entraîner le synthétiseur vocal. De ce fait, le rendu audio du système ressemble fortement à sa véritable voix.
Le résultat est qu'Ann retrouve non seulement la capacité de communiquer, mais qu'elle le fait avec une voix qu'elle reconnaît comme la sienne , ce qui a un impact émotionnel considérable. Dans ce cas précis, la technologie lui a non seulement rendu une fonction, mais aussi une part de son identité.
Comment fonctionne un implant de décodage vocal ?
D’un point de vue technique, le processus qui permet de convertir les pensées en parole grâce à un implant peut être divisé en plusieurs étapes, toutes étroitement coordonnées et prises en charge par des modèles d’intelligence artificielle.
Tout d'abord, lorsqu'une personne tente de prononcer un mot ou une phrase , même si elle ne peut pas bouger les muscles de sa bouche, des schémas électriques complexes se produisent dans son cortex cérébral. Les électrodes de l'implant enregistrent ces variations de tension avec une très haute résolution spatiale et temporelle.
Ensuite, ce signal brut est traité par un système de traitement de données qui le nettoie et le transforme en un ensemble de caractéristiques numériques exploitables par les algorithmes d'IA. Le système doit extraire les informations pertinentes du bruit de fond , qui comprend l'activité neuronale non liée à la parole et d'autres interférences.
Une fois ces caractéristiques extraites, les réseaux neuronaux profonds entrent en jeu. Ces réseaux ont été préalablement entraînés lors de longues sessions où l'utilisateur tente de produire des mots connus tandis que le système enregistre les signaux cérébraux associés . Après de nombreuses répétitions, l'IA apprend à associer ces schémas à des unités linguistiques spécifiques.
Une fois calibré, le modèle peut, au quotidien, prédire le mot ou la séquence de phonèmes que la personne tente de prononcer, simplement en analysant l'activité enregistrée en temps réel. Cette séquence est ensuite envoyée à un synthétiseur vocal, qui génère le son avec une latence très faible, de l'ordre de quelques secondes.
L'amélioration majeure par rapport aux systèmes précédents réside dans le fait qu'il n'est plus nécessaire d'attendre que l'utilisateur termine une phrase complète pour générer la synthèse vocale. Le modèle est capable de mettre à jour en continu ses prédictions à mesure que de nouvelles données neuronales arrivent, ce qui permet une conversation beaucoup plus fluide.
Applications cliniques et perspectives d'avenir des interfaces cerveau-machine invasives
La capacité de transformer ses pensées en paroles quasiment en temps réel a des implications considérables pour les personnes souffrant de troubles de la parole liés à la SLA, à un AVC, à une lésion médullaire haute ou à d'autres affections neurologiques. Pour nombre d'entre elles, retrouver une expression rapide peut transformer radicalement leur quotidien.
Une interface cerveau-ordinateur fonctionnant avec une telle fluidité permet non seulement de répondre par oui ou par non, mais aussi d'exprimer des nuances, des émotions et des opinions complexes . Ceci a un impact positif sur la qualité de vie, l'autonomie et le bien-être psychologique des patients et de leurs familles.
Au-delà de la parole, les chercheurs envisagent d'étendre ces méthodes de décodage à d'autres fonctions cognitives affectées par une lésion , comme la planification motrice ou certains aspects de la mémoire. En théorie, si les schémas neuronaux impliqués peuvent être enregistrés et modélisés, il serait possible de concevoir des systèmes d'assistance ou de réadaptation personnalisés.
En neurosciences fondamentales, ces outils offrent une perspective unique sur la manière dont le cerveau représente le langage, les intentions communicatives et la sémantique à grande échelle. La capacité de décoder en temps réel ce que le cerveau tente de communiquer fournit des données auparavant impossibles à obtenir avec une telle précision.
Cependant, ce potentiel s'accompagne de défis importants : interventions chirurgicales délicates, effets secondaires possibles à long terme et coûts encore très élevés . C'est pourquoi, parallèlement au développement des implants, un second axe de recherche a pris un essor considérable : les neurotechnologies non invasives pour la lecture des pensées.
Neurotechnologies non invasives : lire les pensées sans chirurgie
Ces dernières années, des résultats frappants ont été publiés par des groupes qui, sans ouvrir le crâne, sont parvenus à reconstituer des phrases continues et des descriptions de scènes à partir de l'activité cérébrale mesurée grâce à des techniques telles que l'imagerie par résonance magnétique fonctionnelle (IRMf), la magnétoencéphalographie (MEG) ou l'EEG.
L'une des avancées les plus commentées est le « sous-titrage mental », mis au point par une équipe de neuroscientifiques japonais. Grâce à l'IRMf et à des modèles de langage avancés, ils ont créé un système capable de générer des textes décrivant avec une précision surprenante ce qu'une personne voit, imagine ou entend.
Ce système ne se contente pas de produire des phrases sur des stimuli externes (par exemple, une vidéo que le sujet regarde), mais peut également saisir certains aspects de la façon dont le cerveau se représente le monde intérieurement avant que ces contenus ne soient formulés sous forme de mots conscients.
Les chercheurs ont entraîné l'IA à l'aide de plus de 2 000 vidéos et de leurs sous-titres , convertissant chacune d'elles en une « signature sémantique » numérique. Parallèlement, ils ont mesuré l'activité cérébrale de plusieurs volontaires par IRMf pendant qu'ils visionnaient ces mêmes vidéos. Le modèle a ainsi appris à associer des schémas cérébraux spécifiques à des signatures sémantiques particulières.
Ensuite, lorsque le système reçoit une nouvelle image de l'activité cérébrale en réponse à une vidéo qu'il n'a pas vue, il est capable de prédire quelle signature sémantique est la plus probable et, à partir de là, de générer des phrases avec un autre modèle de langage qui se rapprochent le plus de ce que la personne perçoit ou imagine.
Un autre progrès majeur est dû à des groupes comme Meta AI et l'Académie chinoise des sciences, qui ont démontré qu'il est possible de reconstruire des phrases continues à partir de la MEG , une technique qui enregistre les minuscules champs magnétiques générés par l'activité neuronale sans avoir besoin d'électrodes implantées.
Dans ce cas précis, la clé a résidé dans la combinaison de la magnétoencéphalographie (MEG) avec des modèles de langage de type Transformer , similaires à ceux utilisés par les messageries instantanées les plus avancées. Au lieu de se concentrer sur l'identification de phonèmes individuels, les systèmes analysent les schémas magnétiques globaux et laissent le modèle de langage « compléter » la phrase la plus probable en fonction du contexte.
Du bruit au sens : comment l'IA nettoie et comprend les signaux cérébraux
Traditionnellement, l'un des problèmes des techniques non invasives comme la MEG, l'IRMf ou l'EEG est que le signal utile est noyé dans un bruit de fond important . L'activité cérébrale est extrêmement complexe, et ce qui nous intéresse pour le décodage du langage ou des images ne représente qu'une infime partie de l'ensemble des processus qui se déroulent simultanément.
En magnétoencéphalographie (MEG), par exemple, lorsque nous pensons à un mot ou entendons une phrase, des milliers de neurones s'activent simultanément , générant des champs magnétiques minuscules. Les détecter depuis l'extérieur du crâne revient à essayer d'entendre un murmure dans un stade rempli de gens qui hurlent.
La stratégie actuelle pour surmonter cet obstacle repose sur la reconstruction sémantique de la parole . Au lieu de tenter de traduire chaque fragment de signal en une lettre ou un son spécifique, les modèles d'IA apprennent à associer des schémas dynamiques complexes à des significations au niveau des mots, des phrases, voire des scènes.
Les architectures comme Transformers permettent au système de prendre en compte le contexte : si une certaine séquence de schémas cérébraux indique que la personne entend ou imagine une histoire , le modèle de langage peut compléter les parties moins claires en fonction de la probabilité d’apparition de certains mots.
Des recherches menées par des équipes chinoises ont également démontré que le cerveau organise le langage de manière hiérarchique. Une première couche reflète l' intention de communiquer , tandis qu'une seconde capture le contenu précis du message. L'identification de ces « couches » permet à l'IA de distinguer le simple bruit de fond de ce qui relève réellement du processus linguistique.
Des modèles comme BP-GPT combinent les données d'imagerie par résonance magnétique fonctionnelle (IRMf), qui offre une grande précision spatiale mais est lente, avec celles de la magnétoencéphalographie (MEG), très rapide mais moins détaillée spatialement . L'IRMf « apprend » au modèle où chercher, puis la MEG fournit un aperçu rapide de l'évolution du langage au fil du temps, améliorant ainsi la capacité à distinguer la parole entendue de la parole imaginée.
De l'image au texte : systèmes MinD-Vis et décodeurs visuels
Outre le langage, l'IA réalise des progrès remarquables dans la reconstruction d'images à partir de l'activité cérébrale . MinD-Vis, un système conçu pour traduire les schémas obtenus par IRMf en images ressemblant étroitement à ce que voit le sujet, en est un bon exemple.
Le processus est à nouveau divisé en un encodeur et un décodeur. L'encodeur utilise des réseaux neuronaux convolutifs pour imiter les étapes du traitement visuel du cerveau et traduire les images d'entrée dans un espace de caractéristiques pouvant être associé au signal cérébral enregistré.
Le décodeur fait l'inverse : il reçoit le schéma d'activité cérébrale et, à l'aide de modèles génératifs basés sur la diffusion , reconstruit une image haute résolution qui ressemble étroitement à ce que la personne voyait réellement.
Dans des travaux récents, des chercheurs de l'université Radboud ont amélioré ces décodeurs en y intégrant des mécanismes attentionnels qui leur permettent de se concentrer sur des régions cérébrales particulièrement informatives lors de la reconstruction. De ce fait, les images générées sont encore plus précises et détaillées.
Bien que ces reconstructions ne soient ni parfaites ni photographiques, elles montrent que la correspondance entre les schémas cérébraux et les informations visuelles est suffisamment robuste pour que l'IA puisse l'exploiter avec succès, ce qui, à moyen terme, pourrait servir de base à des aides visuelles, à des diagnostics ou à de nouvelles formes d'art et de communication.
DeWave et d'autres systèmes EEG qui traduisent les pensées silencieuses
En matière d'électroencéphalographie (EEG), qui mesure l'activité électrique du cerveau grâce à des électrodes placées sur le cuir chevelu, des solutions comme DeWave se distinguent : un système non invasif qui traduit les pensées silencieuses en texte . Ici, fini les machines encombrantes et les blocs opératoires ; un simple bonnet muni de capteurs suffit.
DeWave fonctionne en enregistrant le signal EEG pendant que la personne lit silencieusement des phrases ou réfléchit à des mots spécifiques . À partir de vastes volumes de données, des modèles d'apprentissage profond détectent des schémas d'ondes cérébrales corrélés à des significations linguistiques précises.
Le système introduit une technique appelée codage discret , qui transforme les segments EEG en codes numériques uniques organisés dans son propre « dictionnaire de codes ». Chaque code est associé à des mots ou fragments linguistiques voisins dans cet espace, permettant ainsi la construction de phrases.
En pratique, DeWave utilise également un système encodeur-décodeur. L'encodeur, basé sur BERT (un modèle de langage bidirectionnel), convertit le signal EEG en représentations symboliques , tandis que le décodeur, de type GPT, transforme ces symboles en mots écrits.
Les résultats ne permettent pas encore une conversation fluide et en temps réel, mais il est déjà possible de saisir le sens général de phrases complètes et de nombreux mots-clés . Il subsiste des erreurs grammaticales et un certain manque de fluidité, mais le « pont technique » entre les ondes cérébrales et le texte écrit est désormais établi.
Peut-on dire que la lecture des pensées est déjà possible ?
Face à toutes ces avancées, il serait tentant d'affirmer que la lecture de pensée est déjà une réalité quotidienne , mais la situation actuelle est bien plus nuancée. Les technologies disponibles aujourd'hui excellent dans des tâches très spécifiques, réalisées par des personnes hautement qualifiées et dans des environnements contrôlés.
Autrement dit, nous pouvons décoder certains types de pensée ou de perception avec une très bonne précision (par exemple, écouter une histoire, voir une image spécifique ou essayer de prononcer des mots) lorsque le système a été spécifiquement calibré pour cette personne et cet ensemble de stimuli.
Cependant, nous sommes encore loin d'une IA capable de lire le flux continu et spontané de l'esprit humain dans toute sa diversité : souvenirs, pensées abstraites, émotions subtiles, rêveries, rêves… Le défi réside dans le fait que les états mentaux sont extrêmement riches et dynamiques, et que leur reflet dans le cerveau ne suit pas un simple dictionnaire.
Malgré cela, dans des tâches telles que le contrôle du curseur, la prédiction de mots dans un récit ou la reconstruction de scènes visuelles, les taux de précision se sont considérablement améliorés en quelques années seulement. Le développement de modèles de langage et de vision à grande échelle a été un catalyseur essentiel de ces progrès.
Il est raisonnable de supposer qu'avec des capteurs plus performants, davantage de données et des modèles encore plus puissants, la précision et la rapidité de ces décodages continueront de progresser . La grande question est de savoir comment seront gérées les implications éthiques de cette capacité.
Confidentialité mentale, consentement et risques éthiques
La possibilité de déduire ce qu'une personne voit, imagine ou tente de dire suscitera inévitablement d'intenses débats sur le respect de la vie privée . Si l'esprit cesse d'être un espace totalement inaccessible, il sera nécessaire de définir clairement ce qui peut être décodé, quand et dans quelles conditions.
Actuellement, tous ces systèmes nécessitent la participation active de l'utilisateur et de longues séances d'étalonnage . Il est impossible d'espionner quelqu'un à distance avec un casque MEG à son insu, et encore moins de lire dans ses pensées sans un environnement expérimental spécifique.
Malgré cela, les chercheurs eux-mêmes insistent sur la nécessité d'élaborer des cadres juridiques et éthiques pour protéger les informations neuronales, considérées comme des données particulièrement sensibles. Les signaux cérébraux peuvent révéler des aspects de la santé, des préférences, de l'humeur et des processus internes qu'une personne pourrait ne pas souhaiter divulguer.
Il existe également un risque de malentendus : même les meilleurs modèles commettent des erreurs, ce qui peut conduire à des interprétations erronées des signaux neuronaux . Dans les contextes cliniques, juridiques ou professionnels, cela pourrait s’avérer particulièrement grave si l’on n’y prend pas garde.
Il est donc nécessaire de mettre en place des politiques claires en matière de consentement éclairé, de transparence dans l'utilisation des données et de protection stricte de la vie privée , afin que la technologie vise à autonomiser les utilisateurs et non à les surveiller.
Parallèlement, un débat plus philosophique porte sur la mesure dans laquelle la possibilité d'externaliser les pensées et les perceptions peut modifier notre compréhension de l'intimité, de l'identité et de la communication . Il s'agit d'un domaine nouveau qui nécessitera une réflexion commune des scientifiques, des juristes, des philosophes et de la société dans son ensemble.
L'état actuel des neurotechnologies basées sur l'IA pour le décodage de la pensée offre un tableau où, d'une part, des patients ayant perdu toute capacité de parler retrouvent leur voix grâce à des implants cérébraux qui traduisent les signaux neuronaux en parole synthétique quasi instantanément, et d'autre part, des capteurs externes tels que la MEG, l'IRMf ou l'EEG permettent la reconstruction de phrases et d'images sans intervention chirurgicale, grâce à des modèles de langage et de vision à grande échelle. Malgré d'importantes limitations en termes de vitesse, de précision globale et de généralisation aux pensées complexes, la combinaison d'une IA avancée, de nouveaux capteurs et d'une réglementation éthique appropriée laisse entrevoir un avenir où l'écart entre l'activité cérébrale et la communication se réduira progressivement, à condition que la sécurité, le consentement et la confidentialité des personnes bénéficiant de ces technologies soient une priorité absolue.