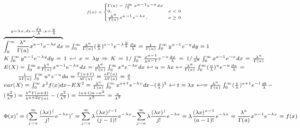
- 方差衡量的是数据集相对于其均值的离散程度。
- 它是通过偏差平方的平均值来计算的,以防止结果相互抵消。
- 它在金融领域是评估风险的基础,在科学领域是确定估计器准确性的基础。
- 它的平方根就是标准差,通过标准差可以还原成原始的测量单位。

当我们深入研究数据时,常常只关注平均值,但简单地说平均值是某个特定值有时会让我们一头雾水。要真正理解信息背后的含义,我们需要知道数据是否高度集中,或者是否存在相当大的离散度,从而导致平均值的可靠性降低。
这时,方差就派上了用场,它是一种可以量化这种变异性的工具。简单来说,它衡量的是一个群体中的数值平均偏离其中心值的程度,从而使我们能够发现那些原本会被忽略的异常值或不一致之处。
方差究竟是什么?
准确地说,方差是衡量离散程度的指标,它描述了数据集相对于其算术平均值的变异性。简单来说,它告诉我们一组数字彼此之间是否非常相似,或者它们是否分散在整个图表中。
从历史角度来看,是罗纳德·费舍尔在 1918 年提出了这个概念。费舍尔意识到,为了分析自然和遗传变异的原因,使用标准差的平方比使用标准差本身要有用得多,从而奠定了现代统计学的基础。
有趣的是,方差始终大于或等于零。这是因为,无论原始偏差是正还是负,当差值平方时,结果在数学上都不可能为负。
指数存在的理由:为什么要平方?
很多人不明白为什么我们不直接将每个数据点与均值之间的差值相加。原因很简单:根据数学原理,所有数据点与均值的偏差之和始终等于零。正值和负值相互抵消,会让我们产生错误的变异性错觉。
通过对这些残差进行平方,我们可以消除负号,并确保任何偏离均值的情况(无论向上还是向下)都会对最终结果产生积极影响。因此,只有当数据集中的所有数据都完全相同时,我们才能得到方差为零的结果。
如何计算:逐步讲解
计算方差并不需要数学天才,只需遵循一定的逻辑顺序即可。首先,我们必须求出这组数据的算术平均值。得到平均值后,我们计算每个数据点与该平均值的差值,这个过程称为获得残差。
下一步是将每个残差平方,然后将它们全部相加。最后,我们将总和除以观测值的数量。这里有一个重要的区别:如果我们处理的是整个总体,则除以 N;但如果只是一个样本,则除以n-1以获得无偏估计量。
随机变量的方差
当我们进入概率论领域时,随机变量 X的方差定义为其与均值偏差平方的期望值。从数学上讲,这可以表示为变量与其自身的协方差,或者表示为概率分布的二阶累积量。
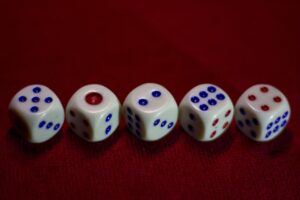
根据变量的性质,计算方法有所不同。如果变量是离散的(例如掷骰子),我们将偏差的平方乘以其概率,然后将所有偏差值相加。如果变量是连续的(例如人的身高),则必须使用概率密度函数在其整个取值范围内的积分。
与标准差的主要区别
这两个概念很容易混淆,因为它们本质上衡量的是同一件事。区别在于单位。方差以平方单位表示(例如,如果我们测量的是米,方差的单位就是平方米),这使得它难以直观理解。
为了解决这个问题,我们对方差取平方根,得到标准差。这样就将度量值还原到其原始单位,使我们能够说,例如,工资与平均值的平均偏差为 200 欧元,而不是说欧元的平方。
实际应用和实际效用
方差并非仅仅是学术探讨,它在现实世界中有着至关重要的应用。在金融领域,方差直接反映了风险。如果两项投资预期收益相同,谨慎的投资者会选择方差较低的那项,因为其结果更可预测。
在工业领域,它用于质量控制。零件制造过程中的低变异性意味着工艺稳定,产品几乎完全相同。另一方面,方差分析 (ANOVA)可以比较不同组别,以确定它们均值之间的差异是否具有统计学意义。
它对于创建高效且一致的估计量也至关重要。如果一个估计量的方差尽可能小,那么它就是高效的,这可以降低我们所抽取的样本与总体真实值偏差过大的风险。
特殊情况和限制
并非所有分布都有方差。例如,柯西分布没有数学期望,因此也没有方差。类似地,有些帕累托分布虽然有均值,但如果其指数落在特定范围内,则没有方差。
另一个缺点是对异常值的敏感性。因为我们对差异进行平方运算,所以一个距离均值极远的数据点就可能大幅增加方差,从而扭曲对数据集整体离散程度的感知。
为了缓解这个问题,一些统计学家使用变异系数,它是标准差与均值的比值。由于它是一个无量纲值,因此可以比较均值差异很大的两组数据的离散程度,而不会受到尺度的影响。
运用方差可以帮助我们理解数据的结构,从简单的薪资样本到复杂的正态分布曲线——方差越小,曲线越高越窄。掌握了方差的概念,我们就能从对平均值的肤浅解读,转向对任何研究现象的变异性进行批判性和深入的分析。