- Jev AI es un modelo de Sistema Uno especializado en devolver decisiones estructuradas y probabilidades en lugar de texto generativo.
- Se diferencia de los LLM tradicionales por su velocidad extrema, coste reducido y la eliminación total de errores de tipo en sus salidas.
- Funciona mediante tres primitivas principales (Choice, Score y Noul) para clasificar, puntuar y validar datos de forma paralela.
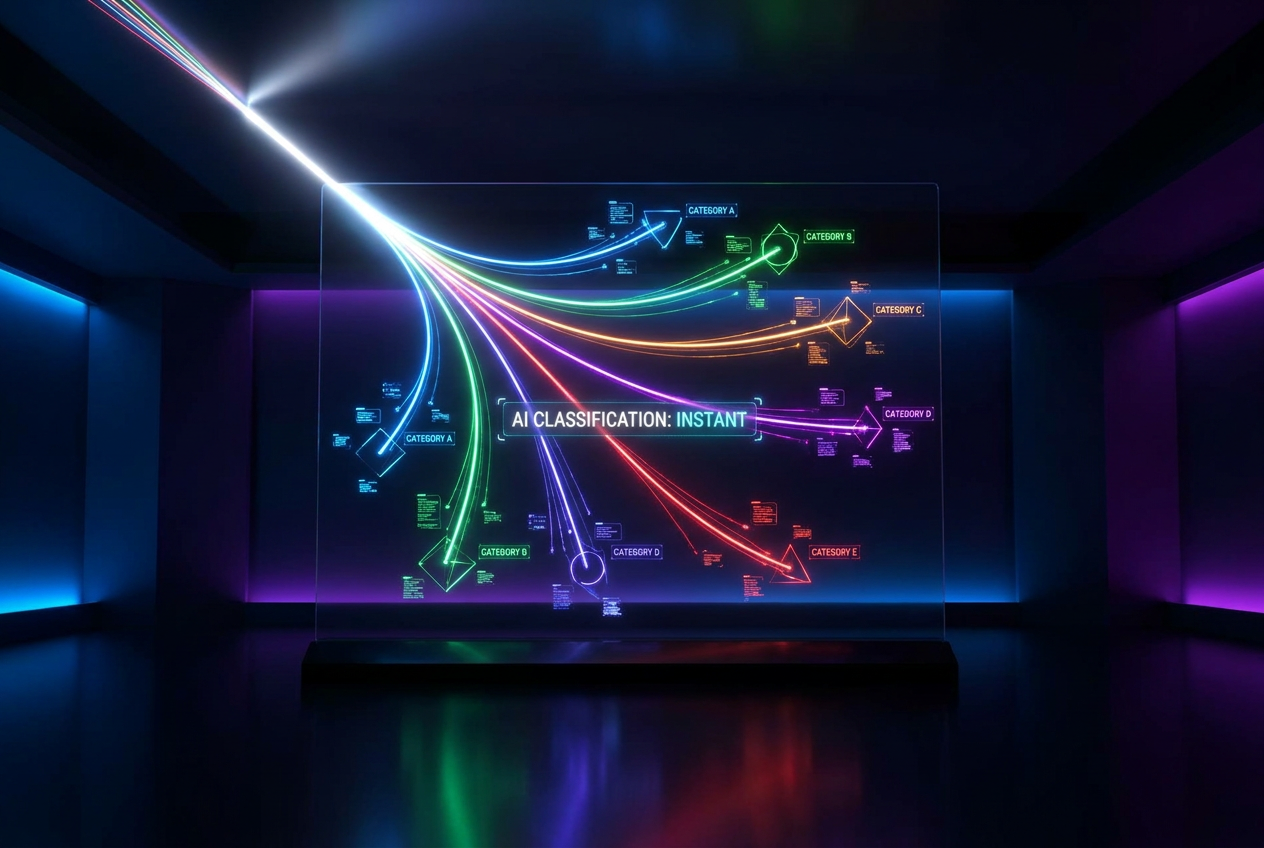
Seguramente estés acostumbrado a que la inteligencia artificial sea ese chat con el que hablas, le pides que te escriba un correo o que te resuelva un problema de código. Pues bien, TypeSafe AI ha decidido romper el molde con el lanzamiento de Jev, una herramienta que pasa totalmente de las conversaciones para centrarse en lo que realmente importa en el software: tomar decisiones rápidas. No estamos ante un chatbot más, sino ante un modelo diseñado para actuar como una pieza de engranaje en una automatización, devolviendo datos que un programa puede entender al instante sin necesidad de interpretar párrafos enteros.
La propuesta es sencillamente disruptiva porque se basa en la idea de que hemos estado usando «cañones para matar moscas». Para tareas como clasificar un ticket de soporte o detectar si un cliente está enfadado, no hace falta un modelo de razonamiento lento y costoso; basta con un juicio intuitivo y veloz. Por eso, Jev se presenta como el primer modelo de Sistema Uno, haciendo un guiño a la psicología de Daniel Kahneman sobre el pensamiento rápido, permitiendo que las empresas procesen millones de juicios semánticos a un precio ridículamente bajo y en una fracción del tiempo que tardaría un LLM convencional.
¿Quiénes están detrás de esta tecnología?
El cerebro detrás de este proyecto es Diogo Almeida, un nombre con mucho peso en el sector ya que formó parte del equipo de OpenAI donde ayudó a dar vida a InstructGPT y ChatGPT. Junto a Erik Gafni y Sasha Sheng, fundaron TypeSafe AI en San Francisco en 2024. La empresa no ha pasado desapercibida para los inversores, habiendo cerrado rondas financieras muy potentes, incluyendo una inversión inicial de 40 millones de dólares liderada por DCVC y, posteriormente, una serie A de 870 millones de dólares impulsada por gigantes como Andreessen Horowitz y Sequoia Capital.
El nombre «Jev» no es casualidad, sino que rinde homenaje a William Stanley Jevons y su paradoja económica. La tesis de TypeSafe es que, al abaratar drásticamente el coste de una decisión inteligente, la demanda de estas implementaciones explotará, permitiendo que la IA se cuele en rincones del software donde antes era prohibitivamente caro o lento meterla.
La arquitectura del «No converse, decida»
La diferencia fundamental entre Jev y modelos como GPT o Claude es que Jev no genera tokens de texto uno tras otro. Mientras que un LLM tradicional es autorregresivo, Jev utiliza un muestreo paralelo. Esto significa que puedes hacerle diez preguntas distintas sobre el mismo texto y te responderá a todas en una sola pasada, haciendo que el tiempo de respuesta sea prácticamente el mismo independientemente de la cantidad de preguntas.
Para lograr que sus probabilidades sean honestas y no simplemente intenten complacer al usuario, han desarrollado un método llamado Reinforcement Learning for Calibrated Decisions (RLCD). El objetivo aquí no es que la respuesta «suene bien», sino que la probabilidad asignada a una respuesta refleje la precisión real del modelo. Así, si Jev dice que tiene un 90% de confianza, es porque estadísticamente acierta en el 90% de los casos, algo vital para decidir si una acción se ejecuta de forma autónoma o requiere supervisión humana.
Las herramientas de decisión: las primitivas
Toda la interacción con Jev se resume en tres tipos de preguntas cerradas, que evitan que el modelo se invente cosas:
- Choice (Elección): El modelo elige una opción de una lista predefinida (hasta 255 opciones). Devuelve la opción ganadora, el mapa de probabilidades de todas las opciones y un nivel de confianza.
- Score (Puntuación): Evalúa el estado según una escala ordenada (de 2 a 10 niveles). Lo interesante es que devuelve un valor numérico que puede caer entre niveles (por ejemplo, 1.4), ofreciendo un matiz mucho más fino que un simple número entero.
- Noul: Es la versión booleana (sí o no). Devuelve una probabilidad entre 0 y 1, donde los extremos son certezas y el 0.5 indica que el modelo no está seguro.
Además, en versiones más recientes como la 1.14, se ha introducido de forma experimental la primitiva Box, que permite localizar elementos dentro de una imagen, aunque esta función todavía no se recomienda para entornos de producción crítica.
Rendimiento, costes y la realidad de los números
En el papel, las cifras son impactantes. TypeSafe habla de latencias que oscilan entre los 70 y 500 milisegundos y un coste de entrada de 0,042 dólares por millón de tokens, con la particularidad de que la salida es gratuita. Afirman que puede llegar a ser cientos de veces más rápido y barato que los modelos de frontera. Sin embargo, hay que leer la letra pequeña: estas pruebas se hicieron en sus propios entornos y desde la Costa Oeste de EE. UU.
Para quienes operamos desde España, la latencia de red añade un lastre. Una petición puede tardar algunas décimas de segundo extra solo en viajar hasta los servidores de Oregón. Aun así, para la mayoría de automatizaciones de WhatsApp o emails, este tiempo es insignificante frente a los segundos que tarda un LLM en generar una respuesta redactada. En cuanto al precio, para una pyme con volumen bajo, la diferencia económica es mínima, pero para quien procesa millones de interacciones, el ahorro es masivo.
¿Dónde brilla Jev y dónde se queda corto?
Este modelo es el rey absoluto en tareas de triaje y enrutamiento. Clasificar tickets de soporte, moderar contenido, detectar fraudes o puntuar la frustración de un cliente son sus especialidades. También es ideal como capa de seguridad (guardrails) para supervisar que otros modelos de IA no estén diciendo barbaridades antes de que el mensaje llegue al cliente final.
Por el contrario, intentar usar Jev para escribir un poema, generar código o explicar un razonamiento es un error, ya que no puede generar texto libre. También tiene debilidades claras: no es bueno con las matemáticas, se marea con las fechas y puede perder precisión si el texto de entrada tiene demasiado ruido o contenido irrelevante. La regla de oro es: deja los cálculos y las fechas al código y usa a Jev solo para el juicio semántico.
Integración técnica y ecosistema
Para ponerlo en marcha, TypeSafe ofrece un Playground en su consola web para probar prompts sin programar. Para los desarrolladores, existen SDKs oficiales en Python y JavaScript, y se integra fácilmente a través del AI Gateway de Vercel o OpenRouter. No es un software que se descargue para ejecutar en local, sino que funciona estrictamente mediante API.
En cuanto a la privacidad, los datos se procesan en Estados Unidos. Aunque la empresa asegura que no entrena sus modelos con la información de los clientes, es fundamental filtrar datos personales sensibles antes de enviarlos, especialmente en sectores regulados como la salud, para cumplir con la normativa del RGPD.
Jev representa un cambio de paradigma donde la IA deja de ser un interlocutor para convertirse en un motor de decisiones estructuradas. Al eliminar las alucinaciones de formato y reducir los costes a niveles casi insignificantes, permite construir flujos de trabajo donde la máquina decide la ruta y el humano solo interviene cuando la confianza del modelo cae por debajo de un umbral crítico, optimizando así la operatividad de cualquier sistema de automatización moderno.